今天想聊一下,各类 AI 背后用的搜索 API。
最开始,大模型其实没有工具。它只用自己的内生知识回答问题。但后来大家发现,模型会有幻觉:它说得很像那么回事,事实却不一定对。所以现在绝大多数 AI 应用——无论是我们日常使用的 App,还是开发者做的 AI 产品——都会接一些搜索 API,目的是帮模型做 grounding。
为什么 AI 搜索需要 grounding?
grounding 的意思,是让模型生成的内容“落在”某些外部、可验证的信息或事实基础上,而不依赖模型参数中的知识或自由生成。grounding 有很多方法,模型可以自己算,也可以去找外部资料。实时搜索网页就是最重要的 grounding 方法。所以有些搜索 API 厂商给自己的定位很直接:『给 AI 用的世界知识搜索引擎』。
为什么不能直接用Google/Bing的接口?
很多人会问:既然已经有搜索引擎,为什么不直接调搜索引擎的接口?
第一个是接口本身的变化。Google 的 Custom Search JSON API 已不再接收新客户,现有客户可使用到 2027 年 1 月 1 日;微软则在 2025 年 8 月 11 日停用 Bing Search API,建议迁移到 Azure AI Agents 的 Grounding with Bing Search。Google 也已经在 2024 年 6 月正式开放 Grounding with Google Search。
第二个原因更重要:模型和人看搜索结果的方式不一样。
人用的搜索引擎,输入几个关键词,拿到一页结果,再一条条点进去看。传统搜索的排序,也是在帮人做这个动作:把最可能被点击的结果排到前面。
模型的阅读方式不同。只要内容能放进上下文,篇幅长一点没有关系;模型也不需要一页页翻。先拿链接、再打开网页、再读正文,速度更慢,也不太符合 AI 的使用方式。模型关心信息相关性,不关心读者会不会点击第一页第一条。所以大部分面向 AI 的搜索 API 都会根据每篇文章的内容做一轮重排(rerank),把真正相关的内容排到前面。
现在的搜索 API,大概分几类?
这五类按最终交付物划分。同一家厂商可以同时提供两三类接口;云厂商、模型厂商和第三方公司都可能出现在同一类里,关键是它替你完成了哪一步。
| 类型 | 代表接口 | 适合什么场景 |
|---|---|---|
| 搜索结果 API(SERP API) | 博查、豆包搜索、小宿智能搜索、Jina Search、Tavily Search、Firecrawl Search 等 | 自己编排 RAG、问答和检索流程 |
| 网页数据 API | Jina Reader、小宿全文展示搜索、Firecrawl Scrape / Crawl / Map / Extract / Agent、Tavily Extract / Crawl / Map 等 | 搜索之后继续读网页、抓取或抽取数据 |
| 模型搜索工具 | OpenAI web_search 等 |
希望模型自己决定是否搜索、搜什么 |
| 联网问答 Agent(Agentic Search) | 火山引擎联网问答 Agent、博查 Agent Search、Kimi Agentic Search 等 | 需要平台 Agent 完成联网问答 |
| 研究型 Agent 服务 | OpenAI deep research、Tavily Research 等 | 竞品分析、选型、长报告和跨来源核对 |
第一类是“给你一批搜索材料”;第二类是“把网页内容读出来”;第三类是“让模型自己使用搜索”;第四类是“让平台 Agent 完成一轮联网问答”;第五类则是“把搜索、阅读和推理一起交给 Agent,完成一份研究”。这样边界更清楚。
Tavily 和 Firecrawl 可以一起看:两家都有第一类的 /search,也都有第二类的网页读取、遍历和抽取接口。后面的分叉是:Tavily 的 /research 属于第四类;Firecrawl 的 /agent 归第二类,交付自主获取的网页数据,不交付研究报告。Tavily 的 API 概览和 Firecrawl API 概览把这些端点分别列出。
Firecrawl 的 /search 默认只交付 URL、标题和 description;请求中加入 scrapeOptions 后,才会连页面内容一起返回。Firecrawl Search API 文档。
小宿也覆盖前两类:智能搜索负责语义检索,全文展示搜索直接返回网页正文。官方产品页把它们写成搜索和内容读取能力,并支持 Markdown、TEXT、HTML 等输出格式。小宿智能搜索。Jina 的 s.jina.ai 把网页搜索和结果页面读取放在一次调用里;r.jina.ai 则专门把已知 URL 转成适合模型读取的内容。Jina API。
垂类搜索:另一条轴
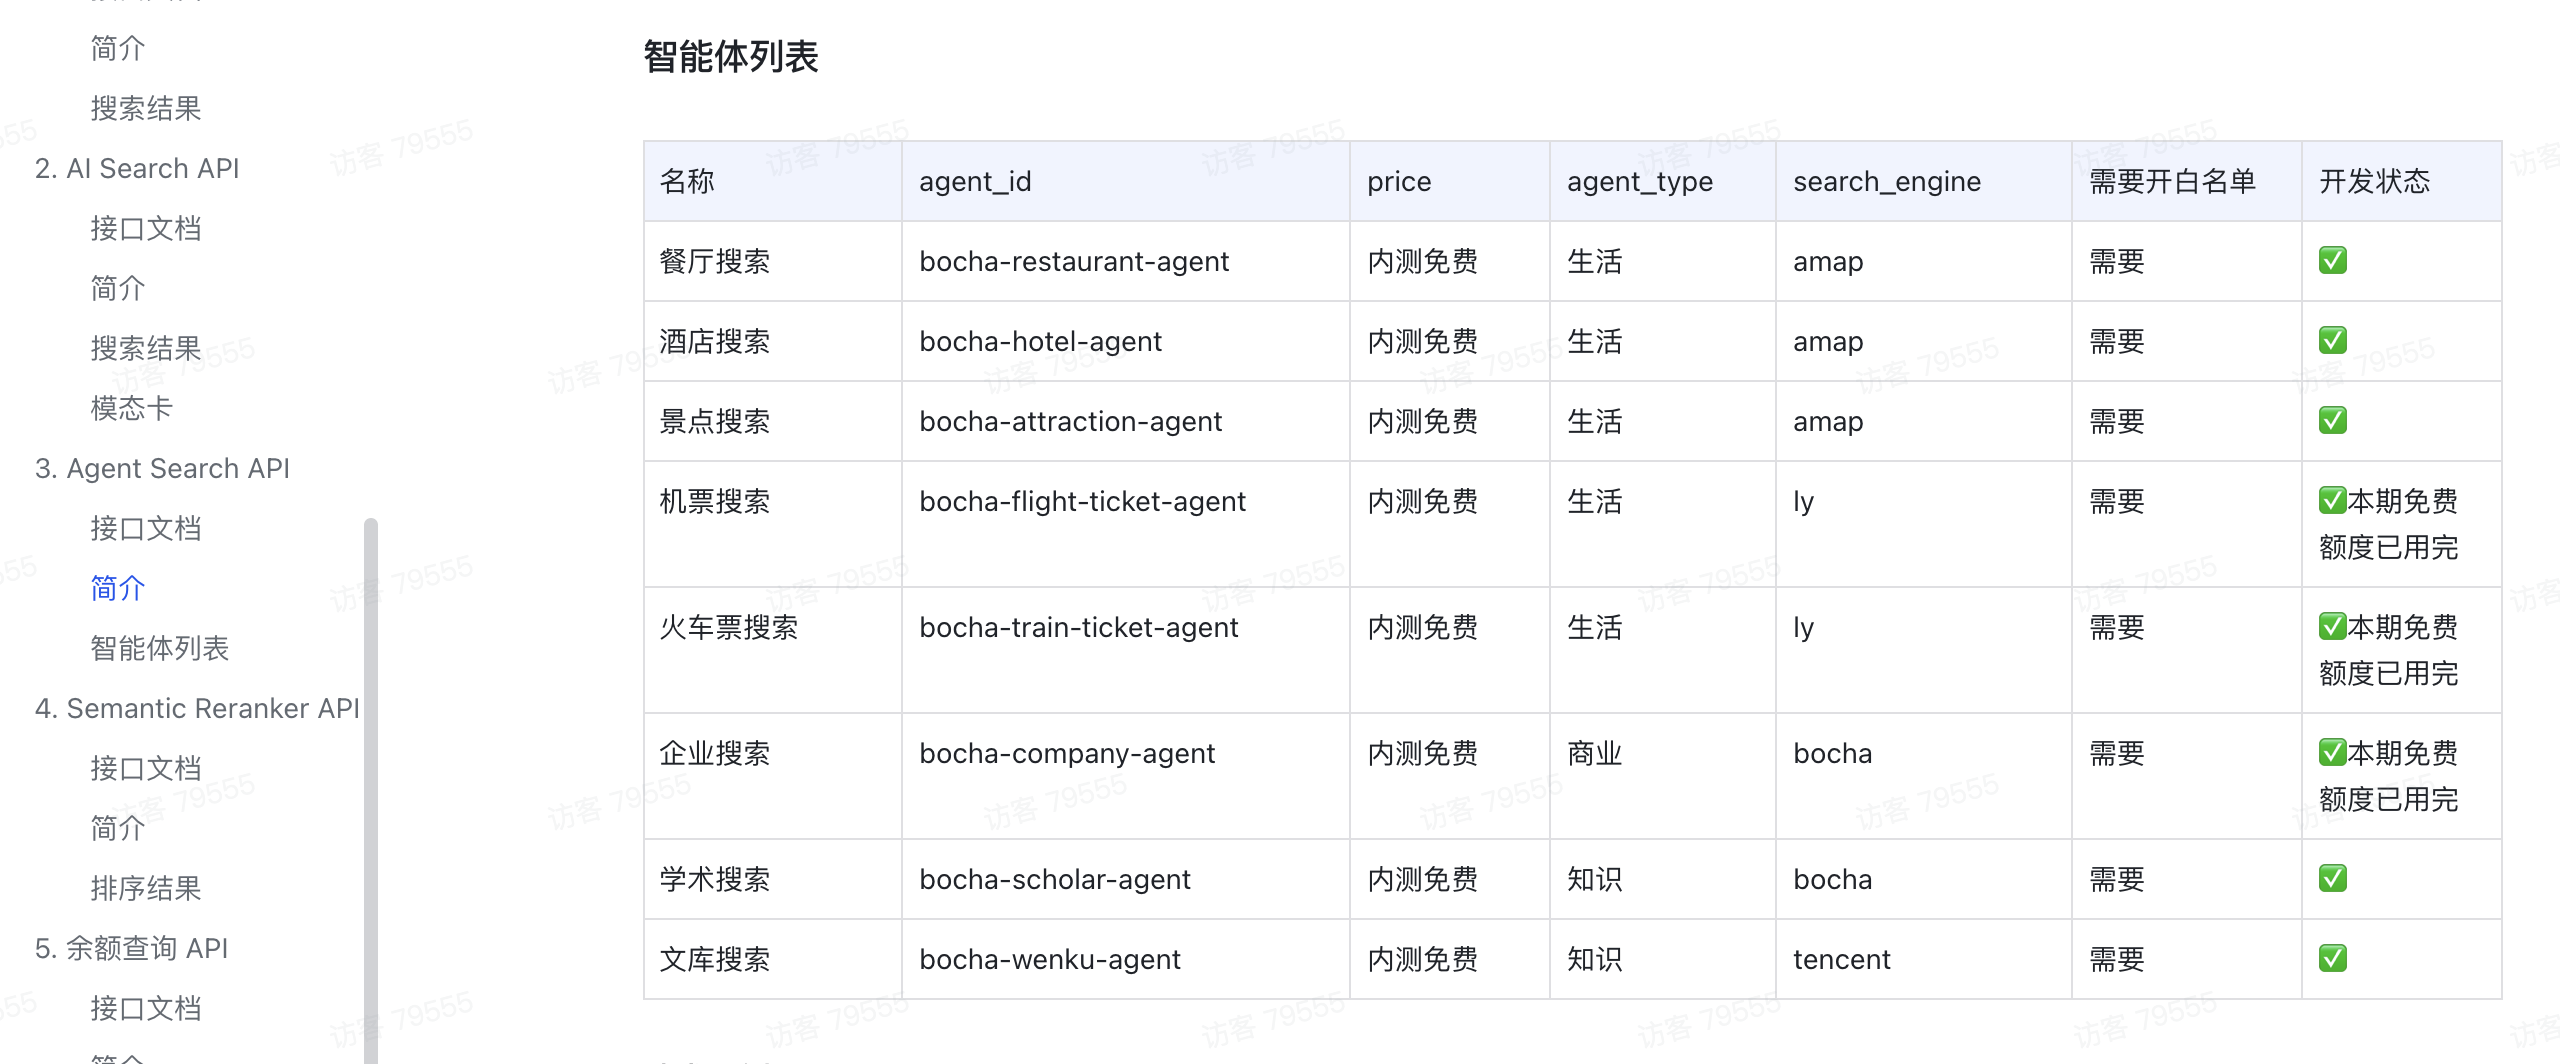
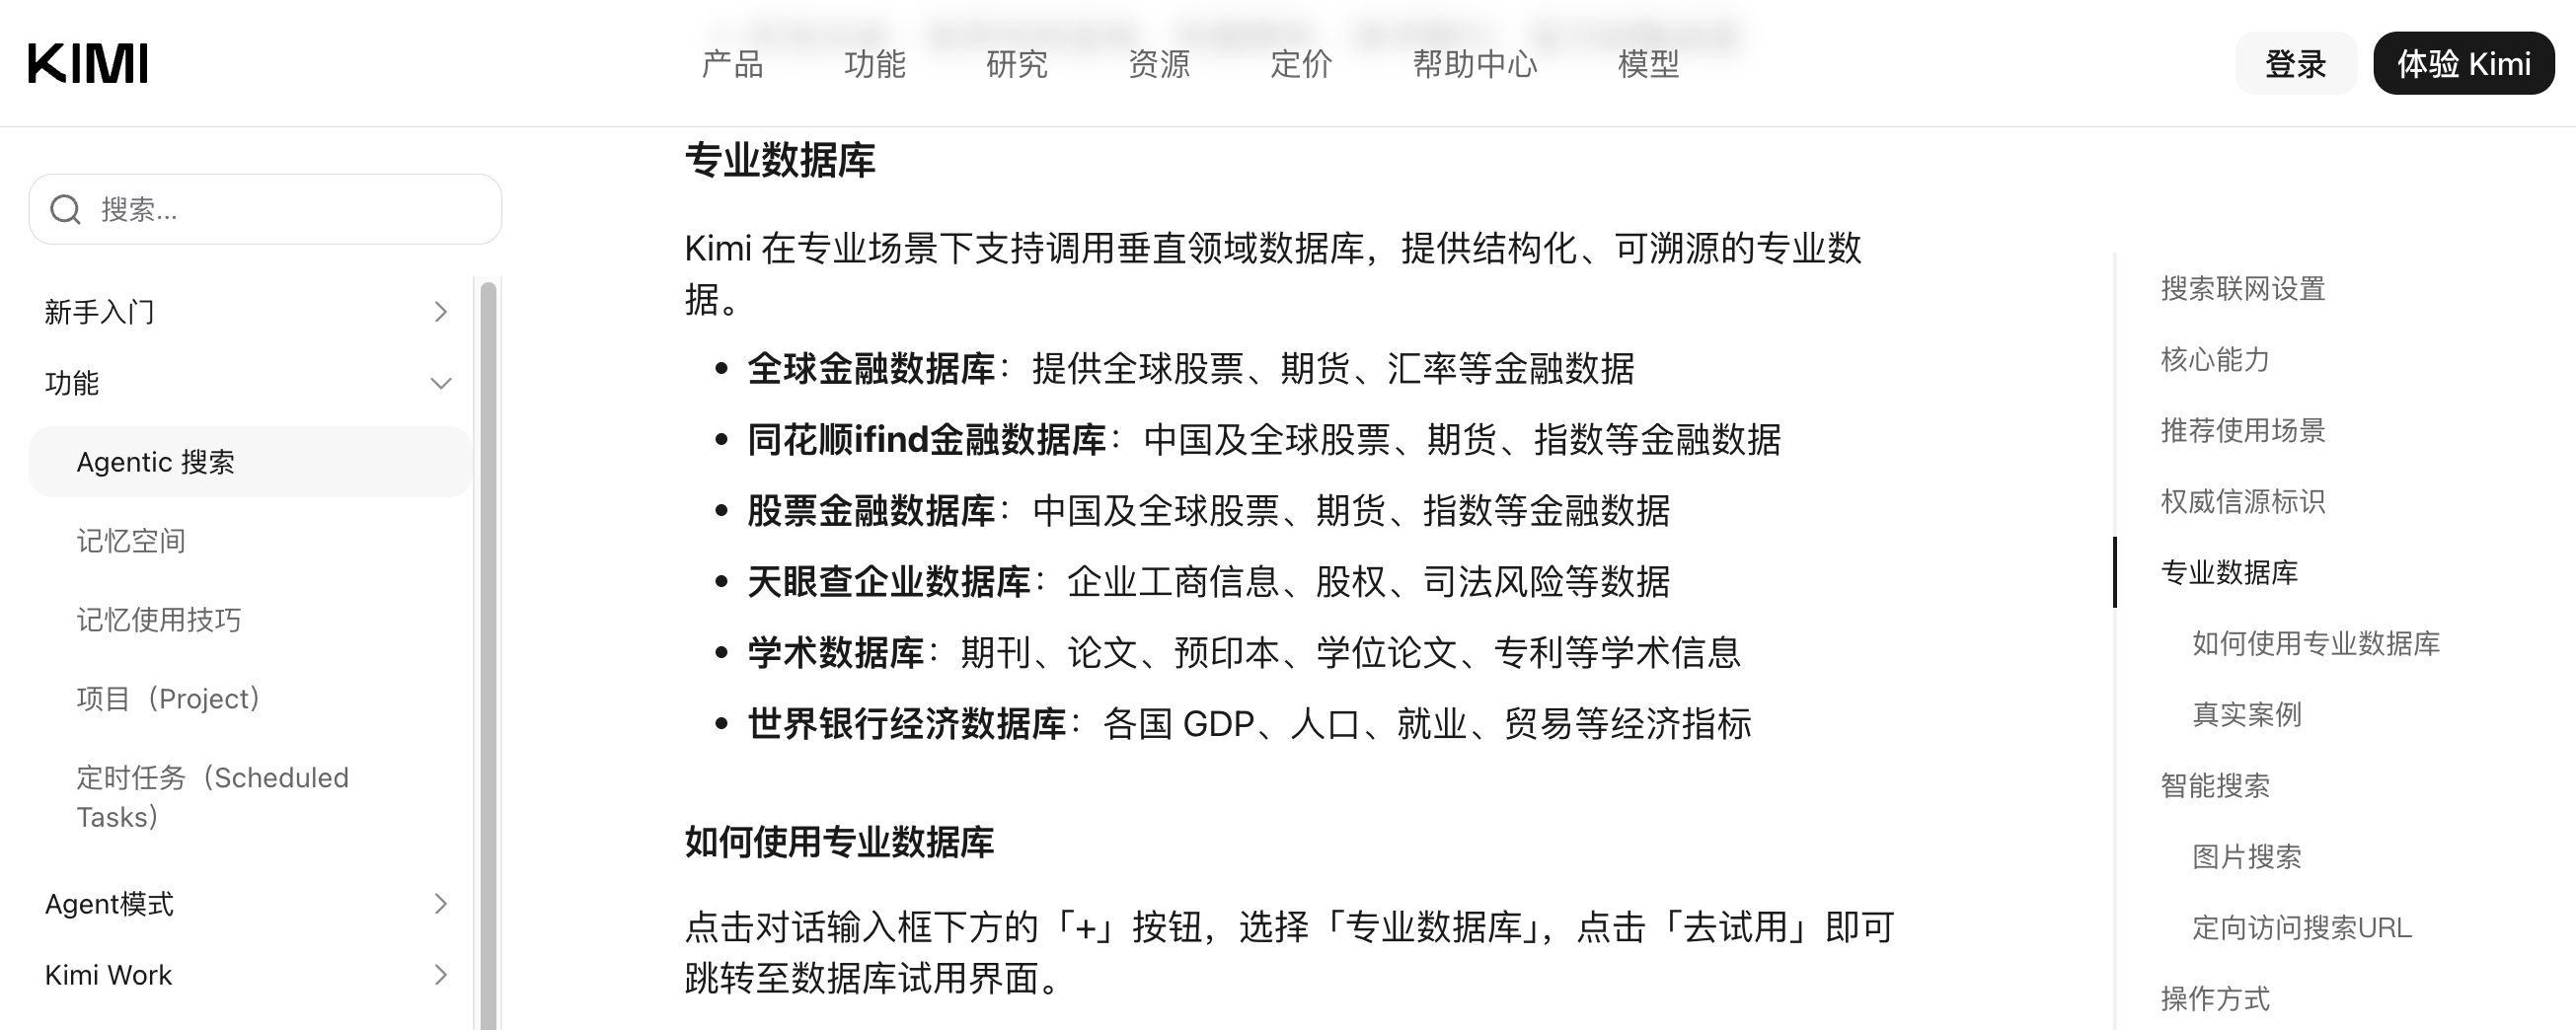
垂类搜索按数据范围划分,和上面的五类接口交叉。博查的 Agent Search 和 Kimi 的 Agentic Search 属于第四类的垂类版本:前者已列出餐厅、酒店、景点、机票、火车票、企业、学术和文库等智能体;后者可调用金融、企业、学术和世界银行等专业数据库。
第一类:搜索结果 API(SERP API)
这类接口最接近英文里的 SERP API,SERP 是 Search Engine Results Page,也就是搜索结果页。博查、豆包搜索这类接口,输入是 query,输出是一批可以继续交给模型处理的搜索材料。它们不一定来自同一种数据源,但接口交付物很接近:URL、标题、摘要、正文片段、时间、相关性或排序信息。
但 AI 搜索里的“搜索结果 API”比传统 SERP API 多走了一步。传统接口主要还原一页搜索结果;这里的接口会把更长的摘要、正文片段和排序信号一起给出来,方便模型直接消费。
Tavily、Firecrawl、小宿和 Jina 的搜索入口也属于这一类:它们接收 query,返回搜索结果、内容或相关性分数;调用方仍然决定 query、结果数量和后续怎么使用这些材料。小宿把搜索结果和网页全文一起提供,Jina Search 也会把检索到的页面转成模型可读内容。Tavily Search 文档、Firecrawl Search API 文档、小宿智能搜索和 Jina API给出的就是这种接口形态。
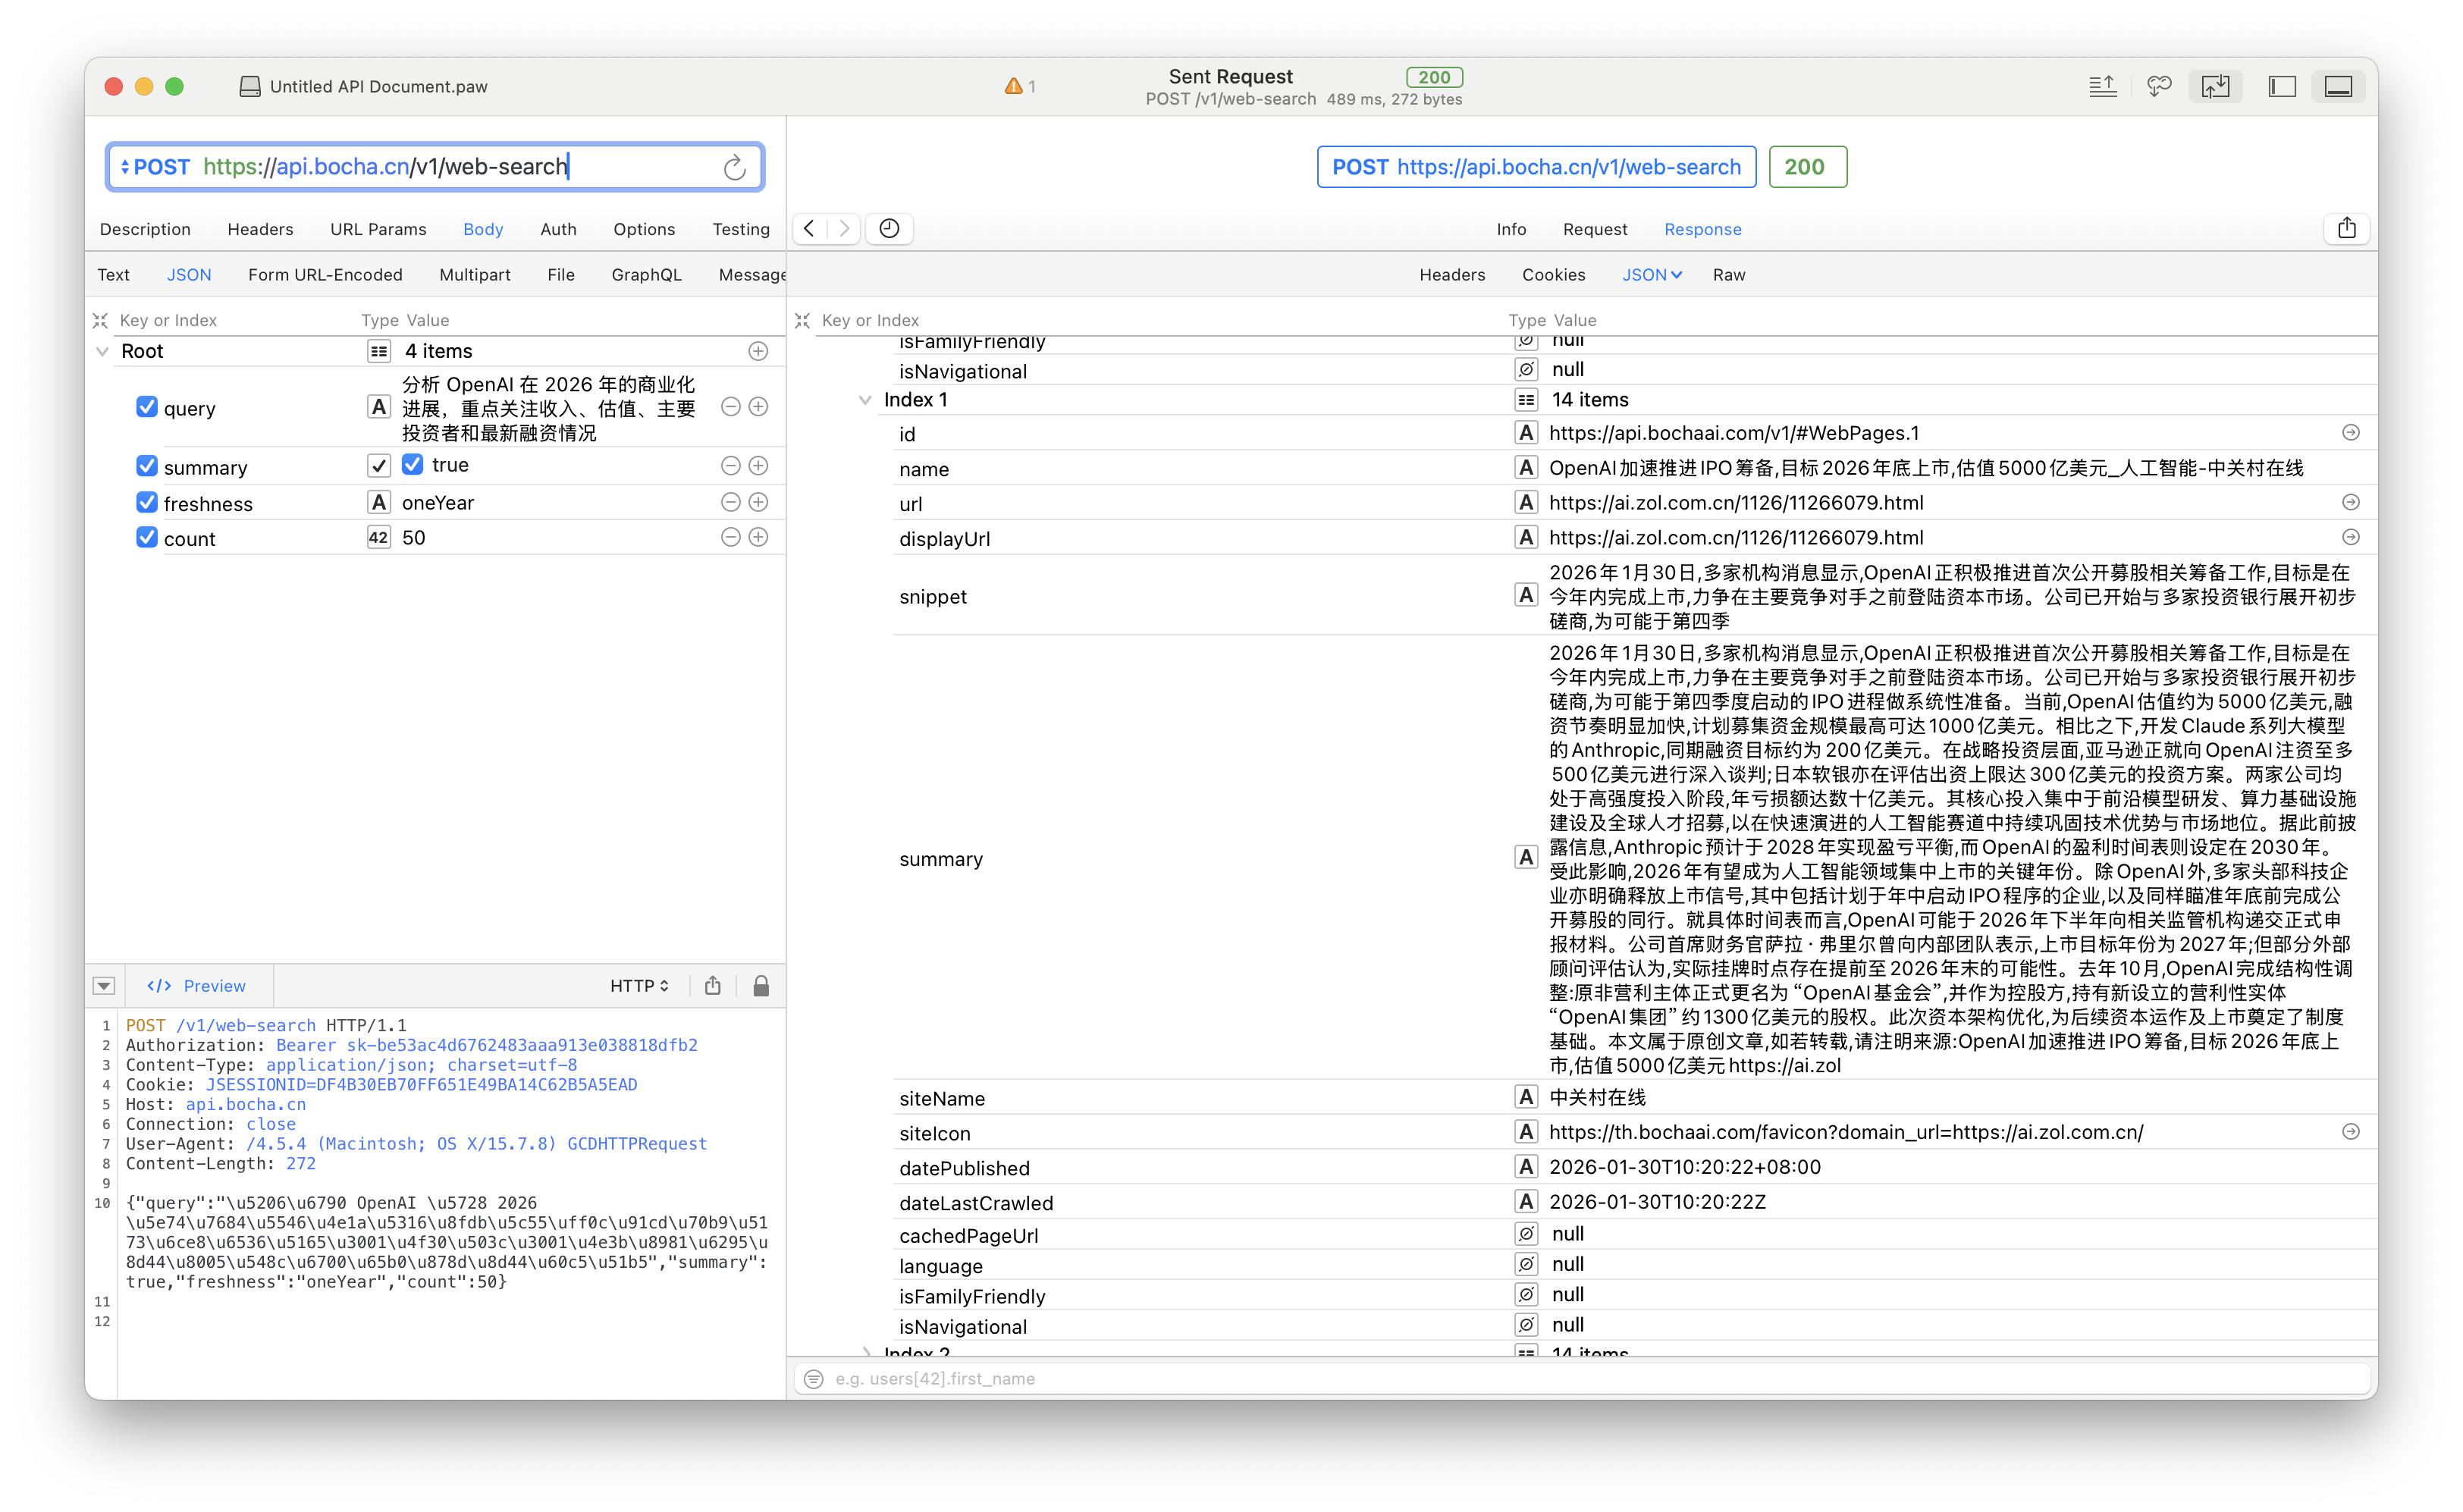
下面是博查的一个实际请求。调用方传入 query、summary、freshness 和 count,返回结果里已经有 URL、snippet、summary、站点名和发布时间。应用不需要再猜“这一页大概讲了什么”,可以直接决定哪些结果交给模型。
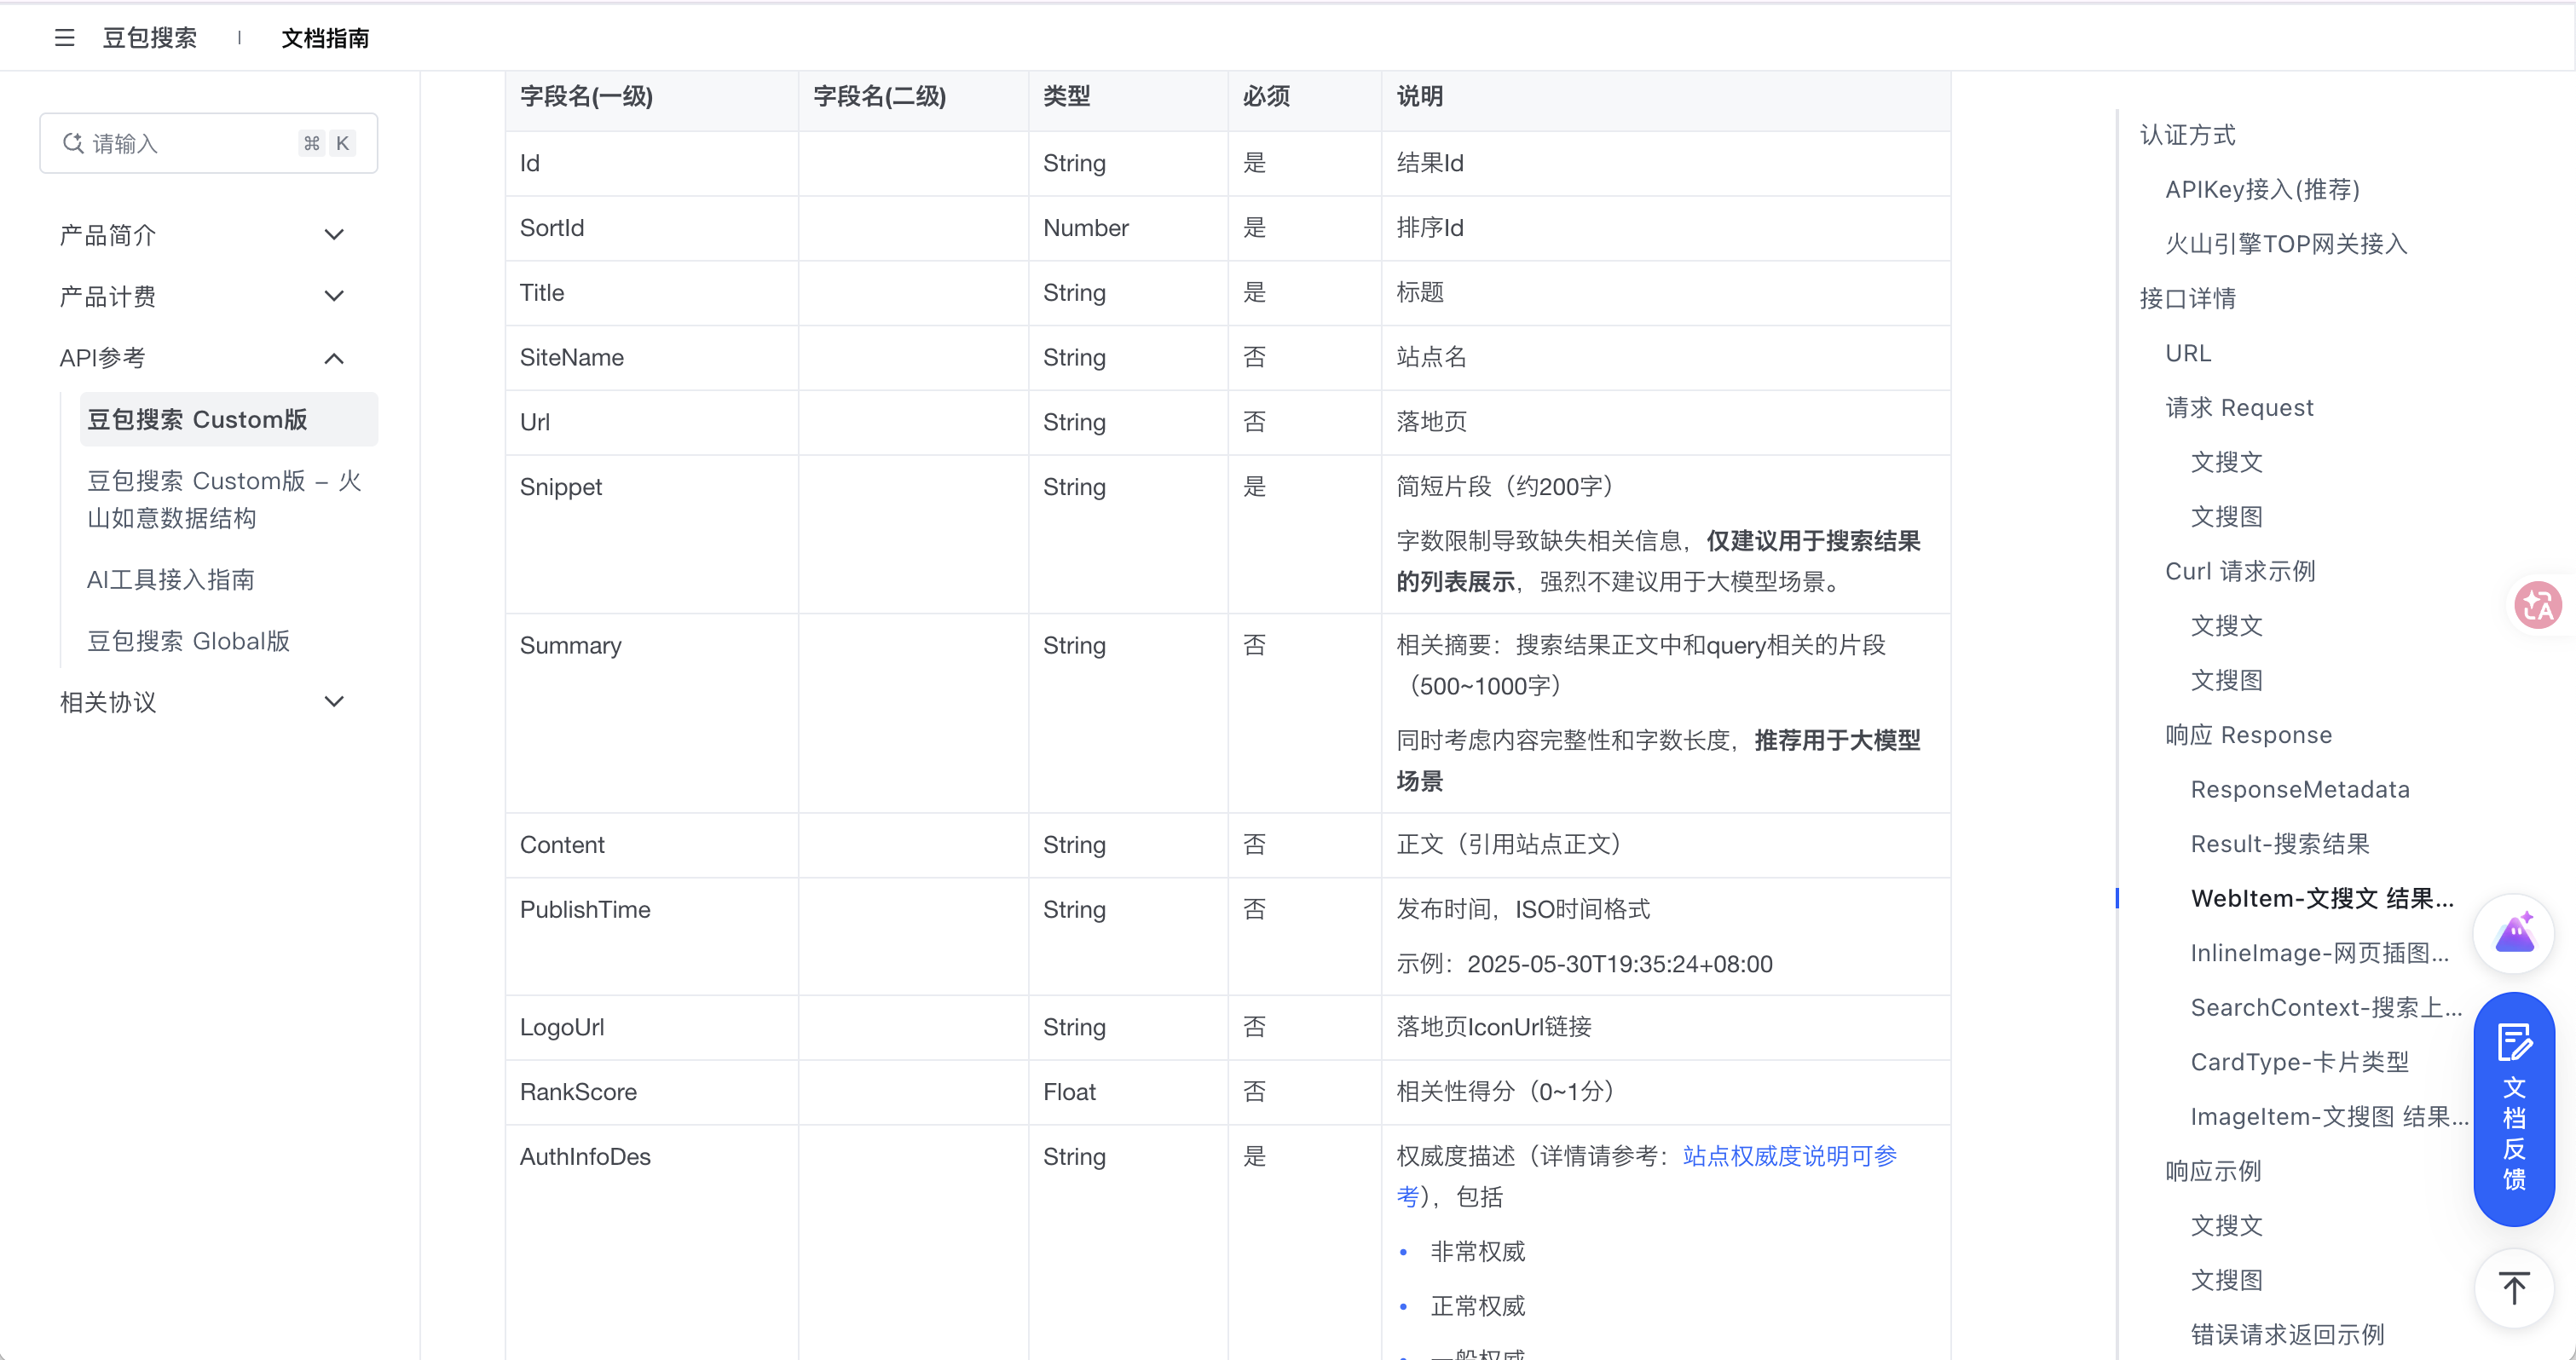
豆包搜索的文档把这个差别写得更明确:Snippet 约 200 字,适合列表展示;Summary 是和 query 相关的 500~1000 字片段,推荐用于大模型场景;接口还可以返回 Content、发布时间和 RankScore。
搜索结果 API 会提前给出模型要读的材料和排序信号,不只是一排“点进去看看”的链接。应用或 Agent 仍然掌握控制权:要拆成几条 query、取多少结果、是否 rerank、最后喂给模型多少内容,都是应用自己决定。
第二类:网页数据 API
搜索拿到的是候选链接,但 Agent 往往还要继续读网页。第二类接口解决的就是这一步。
Tavily 和 Firecrawl 都覆盖这一层。Tavily 提供 /extract、/crawl 和 /map;Firecrawl 除了 /scrape、/crawl、/map 和结构化 /extract,还有按任务自主获取网页数据的 /agent。Jina Reader 和小宿全文展示搜索也在这一层:前者读取给定 URL,后者可在搜索结果中直接交付正文。两家都把 /search 和网页读取分开定义:Tavily 文档和 Firecrawl API 概览。
scrape:读取一个已知 URL,并转成 Markdown 或 JSON;crawl:沿站内链接批量读取;extract:从一组网页中按要求抽取结构化字段。agent:按任务自主寻找网页,并返回需要的结构化数据。
这组接口覆盖网页读取和外部信息抽取。Firecrawl 的 /agent 用于自主获取网页数据,归入第二类;它不属于第三类模型搜索工具,也不交付第四类的研究报告。
第三类:模型搜索工具
第三类的特点是,开发者不再自己编排每一个 query 和页面读取。只需在调用 LLM 时声明可使用 web_search,把问题交给模型;模型再决定是否搜索、搜什么、如何综合结果。
这条时间线要把 OpenAI 的产品搜索和 API 搜索分开看:
- 2024 年 7 月 25 日,OpenAI:发布 SearchGPT 小范围测试原型,面向用户和出版商,还未开放开发者 API。SearchGPT Prototype。
- 2024 年 9 月,Kimi:Kimi API 支持联网搜索,使用
Chat Completions + tool_calls和内置$web_search。当时的发布记录与 Kimi 当前文档。 - 2024 年 10 月 31 日,OpenAI:将 SearchGPT 的能力整合为 ChatGPT Search 产品。Introducing ChatGPT search。
- 2025 年 3 月 11 日,OpenAI:发布 Responses API,并推出服务端内置的
web_search_preview。Responses API 发布说明。 - 2026 年 8 月 13 日,DeepSeek:在 V4-Pro GA 时宣布原生支持 OpenAI Responses API;当前 Responses 文档支持服务端
web_search/web_search_2025_08_26。V4-Pro 发布说明与 Responses API 文档。
第四类:联网问答 Agent(Agentic Search)
这一类已经把联网搜索包装成一个可配置、可调用的 Agent。开发者调用后拿到的是带引用的问答结果,平台自己处理是否搜索、搜索和回答的衔接。
火山引擎的联网问答 Agent 是这个形态:开发者先在控制台创建、配置并发布智能体,再调用智能体会话 API;文搜、图搜、引用和追问等能力由这个 Agent 承担。快速入门和 更新日志。博查 Agent Search 和 Kimi Agentic Search 则进一步接入了垂类数据。
第五类:研究型 Agent 服务
Deep Research 处理更长的研究任务。它让一个 Agent 用多轮搜索、阅读、判断和补查,完成一份研究报告。
以 OpenAI 为例,官方将 deep research 定义为能够在互联网上进行多步研究的 Agent:它会根据遇到的材料调整检索方向,可能搜索、解释和分析大量文本、图片与 PDF;典型任务需要 5 到 30 分钟。Deep Research 的发布说明给出的就是这种工作形态。Responses API 后续提供的后台模式,也正是为了支持需要数分钟的长任务。后台模式说明
Tavily 的 /research 也属于这个交付物层级:它提供面向深入分析的研究接口。Tavily API 概览将它单列为 comprehensive research API。
它增加的是搜索深度和研究流程:
普通搜索 API 交给你一批材料;Deep Research 交给你一个会继续找材料、再组织结论的执行过程。