资料检索日期:2026 年 9 月 5 日
上一篇文章主要讨论了 Google 的专利、AI Mode 和查询扇出的一般机制,也顺带提到 ChatGPT,但没有展开 ChatGPT 自己的证据链。本文转向 ChatGPT,追踪它的 fanout 如何从网页端可见,发展到 API 层可观测,并回答两个问题:
- ChatGPT 是否真实采用了 fanout?
- 我们能否观察到它生成的具体查询?
答案都是肯定的。
官方文档证明机制存在,产品返回数据、Network 响应和 API 则让具体查询变得可见。我们当然看不到厂商没有公开的全部内部原理,但这不妨碍研究者观察真实请求、查询内容和结果结构。
一、OpenAI 官方文档:ChatGPT 明确承认多查询改写
在 Searching the web with ChatGPT 的“Information shared with search providers”一节,OpenAI 明确说明:ChatGPT Search 有时会与其他搜索服务商合作,并通常会把用户查询改写成一个或多个定向查询,发送给这些服务商。
文档还描述了一个分阶段过程:ChatGPT 可能先发送初始查询,在查看初步结果之后,再发送更具体的后续查询。
这段官方说明直接确认了:
- ChatGPT 发出的搜索词不一定等于用户原话;
- 一个用户问题可以对应多个搜索查询;
- 后续查询可能依赖前一轮搜索结果。
这已经回答了第一个问题:fanout 不是社区从引用列表中臆测出来的概念,而是 ChatGPT Search 官方承认的搜索机制。
官方文档没有披露完整内部原理,也没有列出每次请求的全部查询。但对本文的两个问题来说,机制确认已经足够,剩下要看的就是具体查询能否被观察。
二、2025 年:ChatGPT 网页数据曾经暴露具体查询
ChatGPT 的早期实证来自 Nectiv 在 2025 年 10 月发布的 New Data Study: What Queries Is ChatGPT Using Behind The Scenes?。
Nectiv 当时称,ChatGPT 返回的 conversation files / JSON 中包含当次搜索使用的查询,研究者可以从中提取这些数据;也有浏览器工具可以查看单个会话中的搜索查询。
随后,他们把提取方法接入自己的 AI Tracker,对 8,500 多个 prompt 做批量分析,并报告:
- 2,648 次搜索;
- 约 31% 的 prompt 触发搜索;
- 平均每次搜索约 2.17 条查询;
- 单条查询平均约 5.48 个单词;
- 在这组样本中最多观察到 4 条查询。
这项研究的关键不在于“2.17”这个数字,而在于它声称提取的是 ChatGPT 返回数据中的搜索查询,而不是从最终引用反向猜关键词。按这一描述,早期 ChatGPT 的 fanout 曾经以 JSON 数据的形式出现在产品返回结果中。
Nectiv 没有公开完整的提取程序和原始数据,样本也主要集中在商业和购买意图场景。因此,2.17 条和最多 4 条都是该样本中的观察结果,不是 ChatGPT 的固定规则。
三、2026 年:网页端隐藏,API 和 Network 仍可观测
2026 年 3 月 6 日,Nectiv 发布了 ChatGPT 5.4 Has Hidden Fan-Out Queries。
他们观察到,ChatGPT 5.4 网页端已经不再像过去一样,把 fanout 暴露在 conversation files 或 DevTools 中,过去的抓取工具也因此失效。但通过 OpenAI Responses API 并启用 web_search 工具,仍然可以从返回数据中观察相关搜索调用。
这里发生的是可见性变化,而不是 fanout 消失:
| 时间 | 可观测位置 | 说明 |
|---|---|---|
| 2025 年 | ChatGPT 网页端 conversation files / JSON | 搜索查询曾经出现在产品返回数据中 |
| 2026 年 | Responses API + web_search |
云端执行链路仍可能返回搜索相关数据 |
2025 年是从 ChatGPT 网页端的会话数据中提取;2026 年则是直接调用 Responses API,由云端模型和 web search 工具完成搜索,再返回结构化响应,也就是现在常说的 harness API 路径。
这两种方式都能观察具体查询,但观测对象不同:前者接近网页产品返回数据,后者接近 API 的远程执行链路。它们不要求研究者知道模型内部的全部实现,就可以回答第二个问题——具体 fanout 查询确实能够被观测。
2026 年 9 月 5 日:网页端仍可看到搜索查询
今天的实测提供了一个新的观察:在 ChatGPT 网页端的 Network 面板中,可以检索到 search_model_queries;对应响应里出现了 queries 数组,并列出了针对同一个问题生成的多条搜索查询。
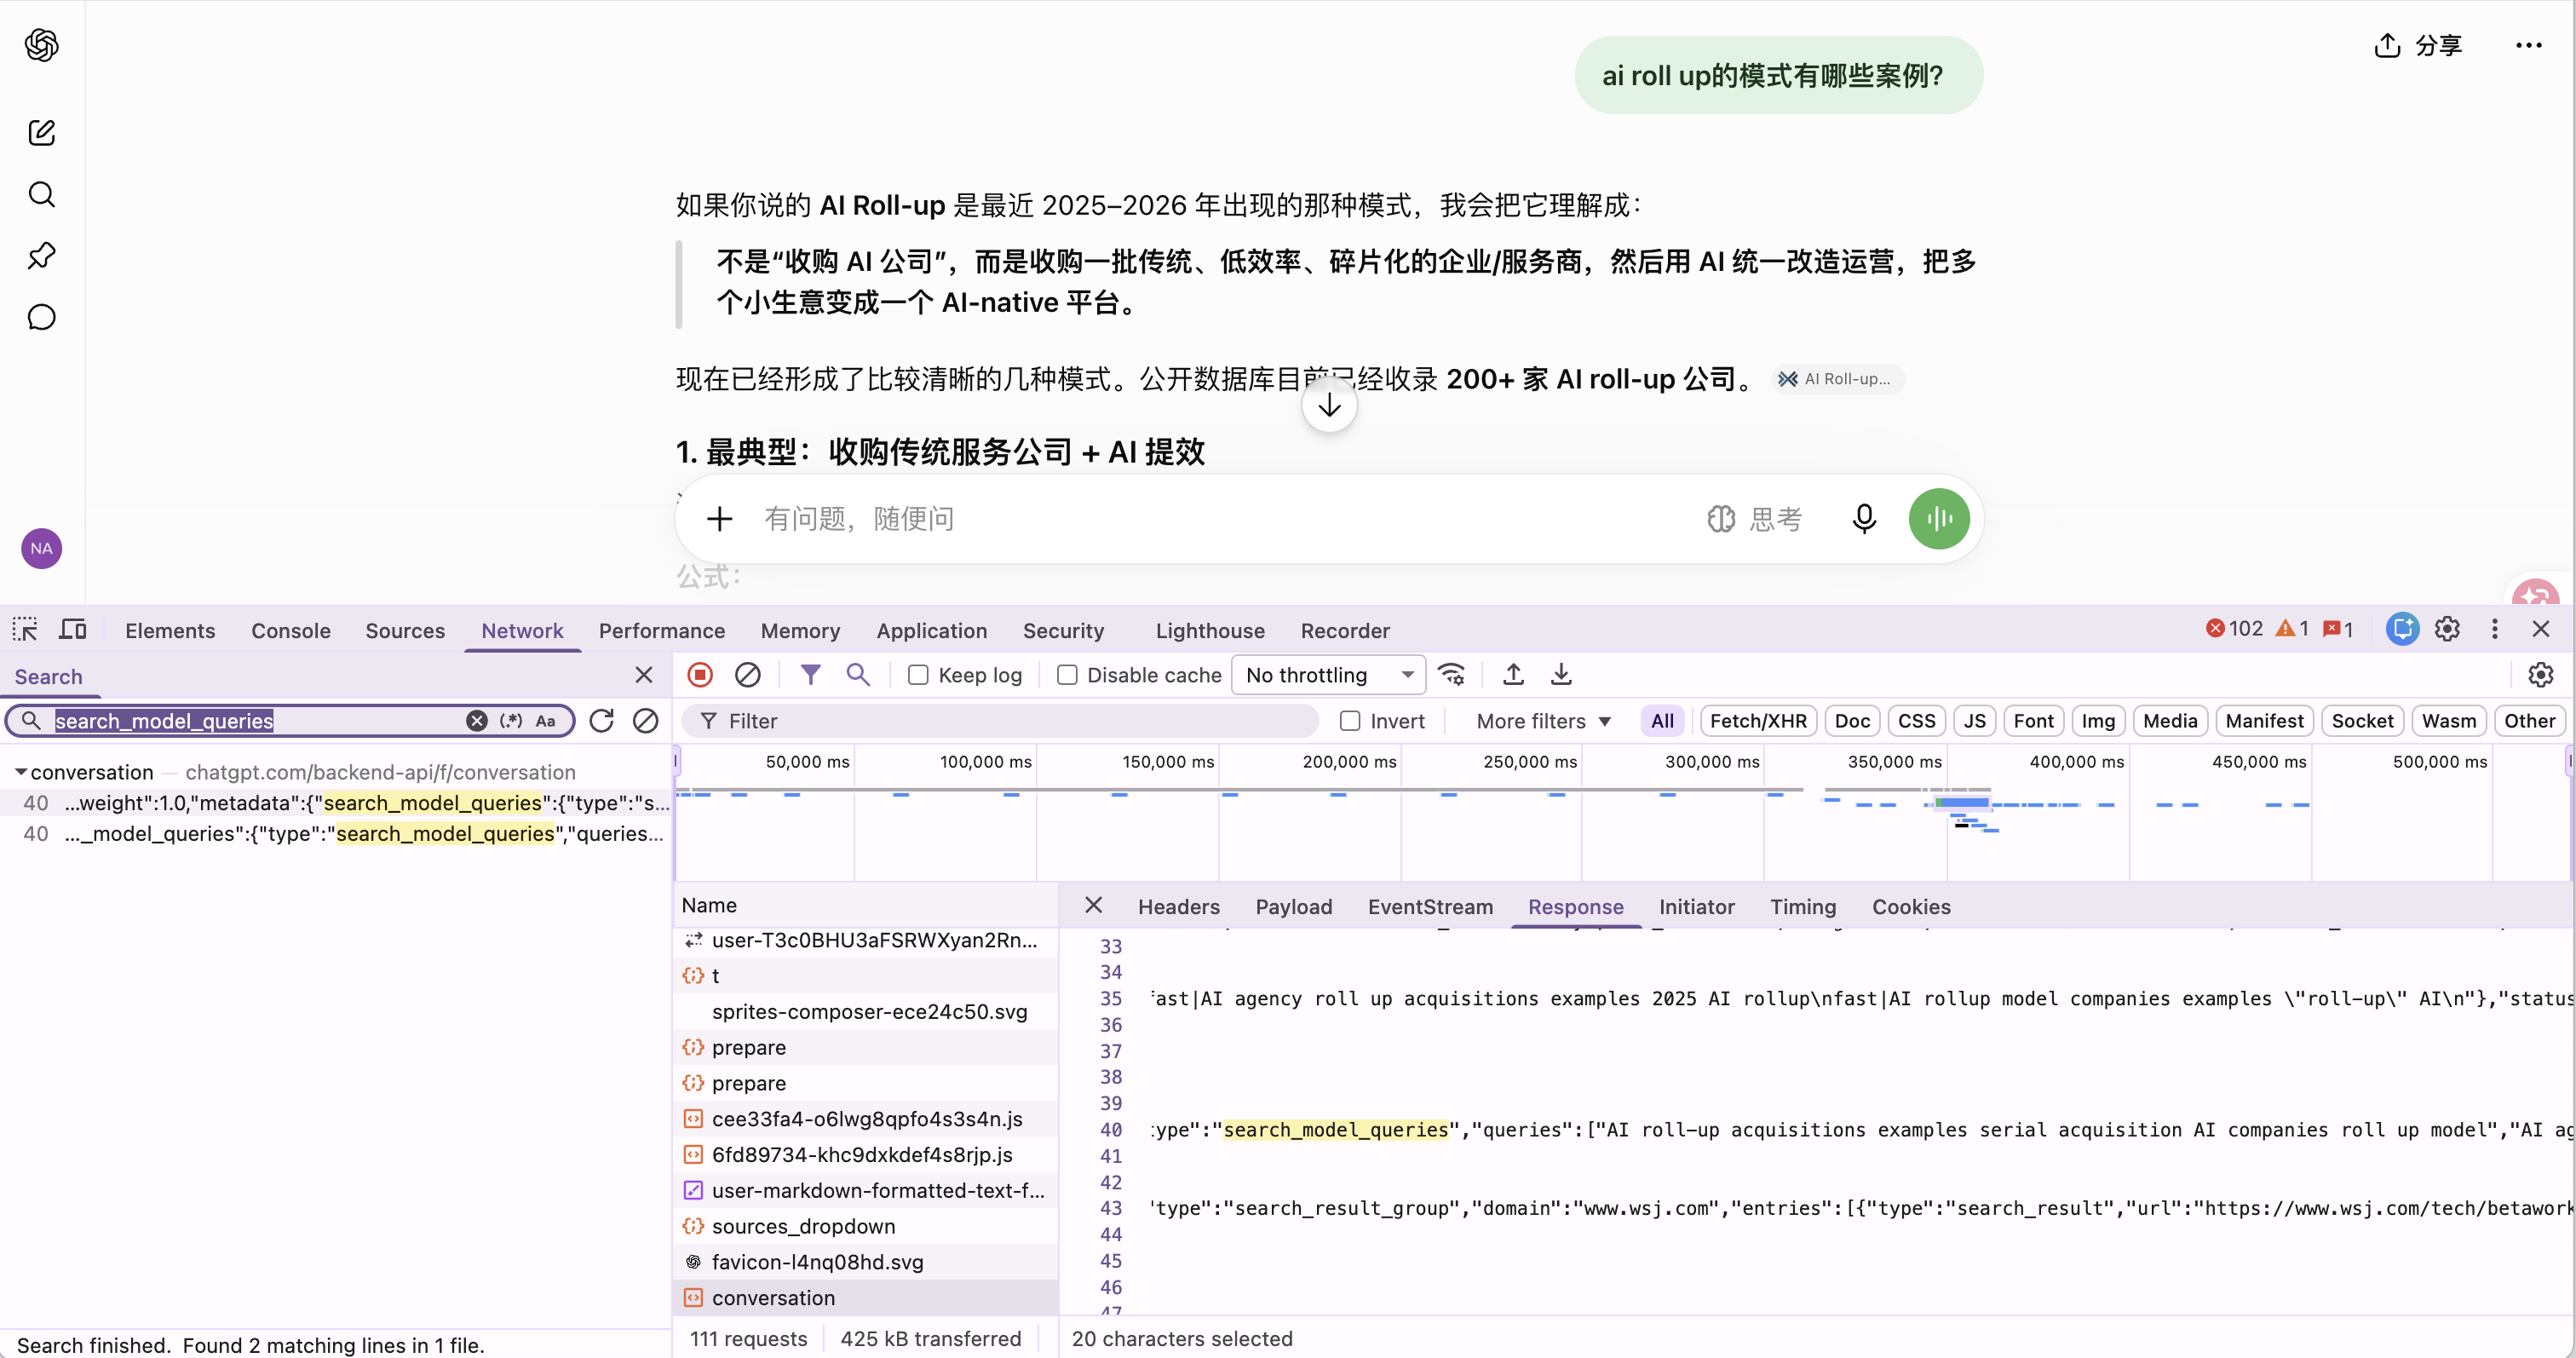
这说明当前版本的网页端仍可能在网络响应中返回搜索查询。它是一次具体请求的实测,不代表所有会话都以同样方式返回,但已经足以作为具体 fanout 的直接观测样例。
四、中国 AI 助手平台的实测:豆包也返回了查询数组
在豆包网页端,我观察到了 search_query_result_block,其中包含 queries 数组。
针对“AI roll-up 模式公司”这个问题,响应中出现了 4 条查询:
- AI roll-up 模式代表公司;
- roll-up 模式是什么,科技行业;
- AI roll-up 国内企业案例;
- AI roll-up business model 收购整合 AI 公司。
响应同时显示“搜索 4 个关键词,参考 20 篇资料”。
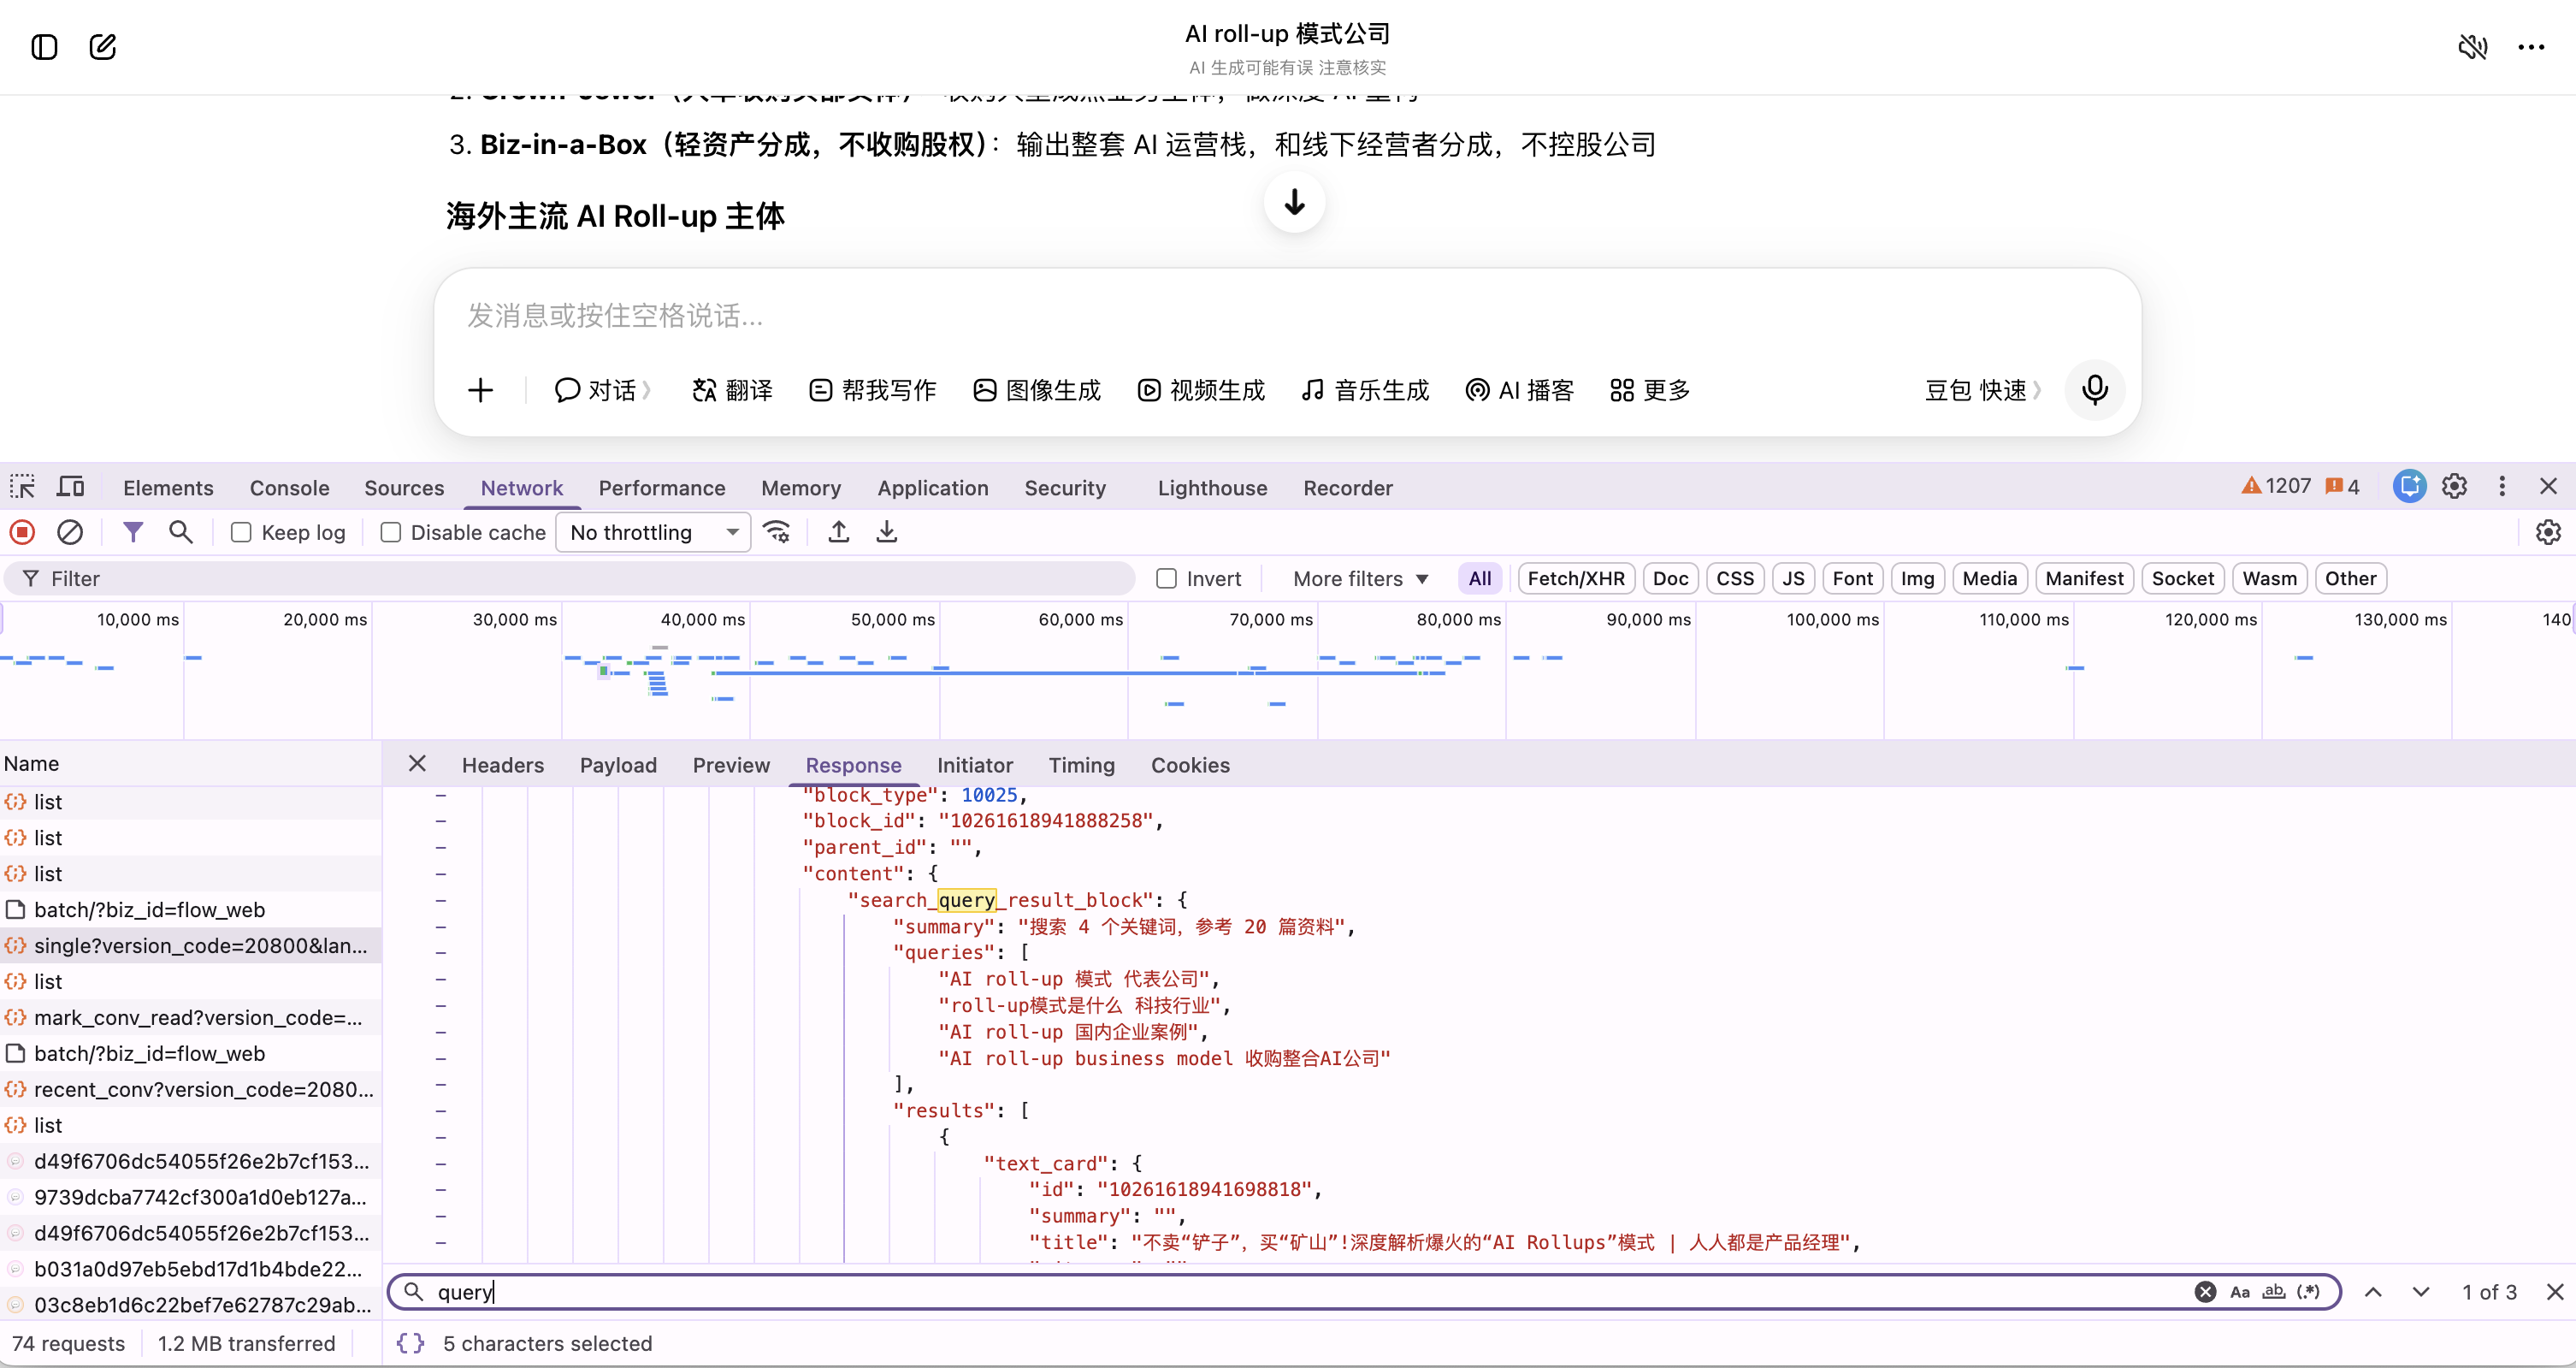
这同样是一个具体问题的一次网页端网络响应实测,不能推出豆包对所有问题都固定生成 4 条查询。但它说明,国内 AI 助手的产品响应中也可以直接观察到一个用户问题展开成多个检索方向。
五、结论:机制真实,细节可观测
现在可以直接回答最初的两个问题:
- fanout 真实存在。 OpenAI 官方帮助文档明确说明,ChatGPT 会把用户问题改写成一个或多个定向查询,并可能根据初始结果继续搜索。
- fanout 细节可以观测。 2025 年的 conversation files / JSON、2026 年的 Responses API 和 Network 响应,都出现过具体的查询字段;豆包网页端也能观察到
queries数组。
这里的“细节可观测”,指的是查询内容、查询数量、查询结构和部分结果关系可以被记录和分析;它不等于厂商公开了完整模型原理,也不等于每次请求的全部内部日志都能被外部取得。
但对研究者来说,这已经是足够有价值的产出:我们不必知道模型内部的每一层实现,也能观察它实际向搜索系统提出了什么问题。
如果你想了解更多关于 AI 助手查询扇出、搜索请求和 GEO 的实测信息,欢迎私信或联系我。